
Artículos / Sistemas de Datos
Anomalías con Kafka y Python: modelo, eventos y offsets
Ejecuta una demo local de Kafka con Python e Isolation Forest: tres particiones, validación de eventos y confirmación de offsets después del procesamiento.
Un productor envía observaciones de dos variables a transactions. Tres consumidores del mismo grupo las evalúan con Isolation Forest y publican las detectadas como anomalías en anomalies. Esta demo local muestra qué confirma Kafka y cuándo se confirma el procesamiento; sus datos sintéticos no representan transacciones financieras reales.
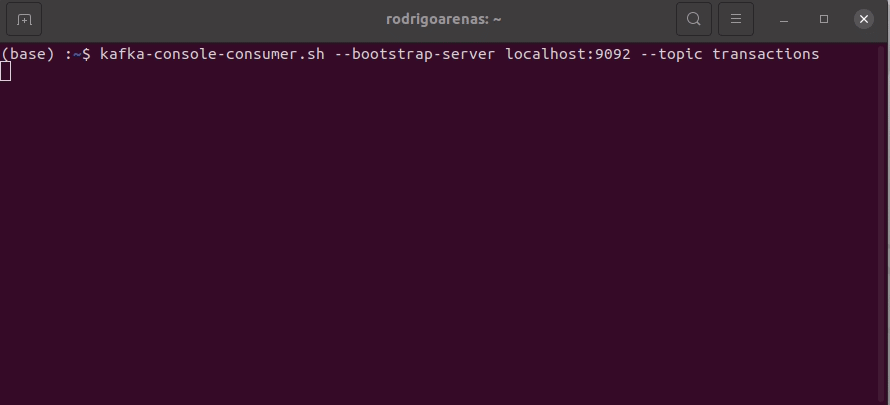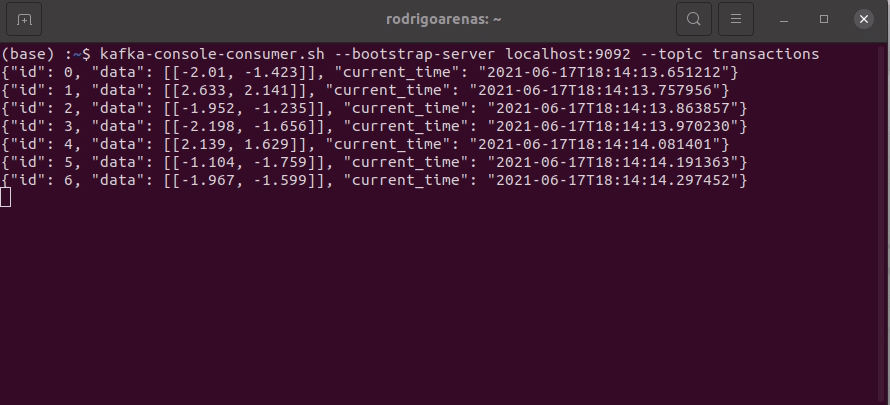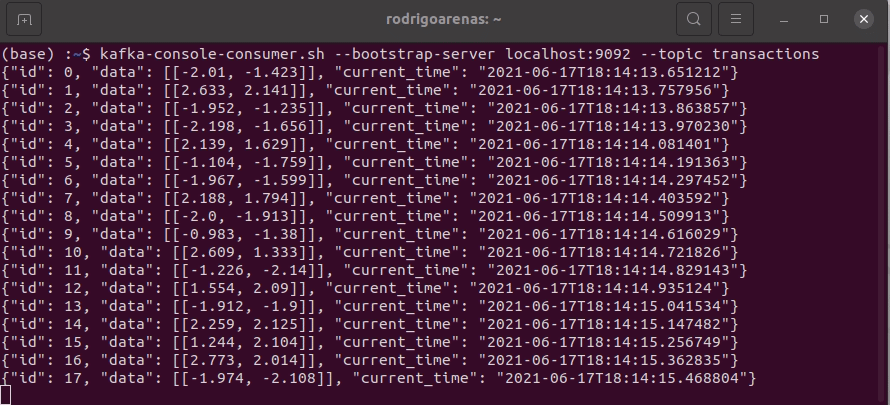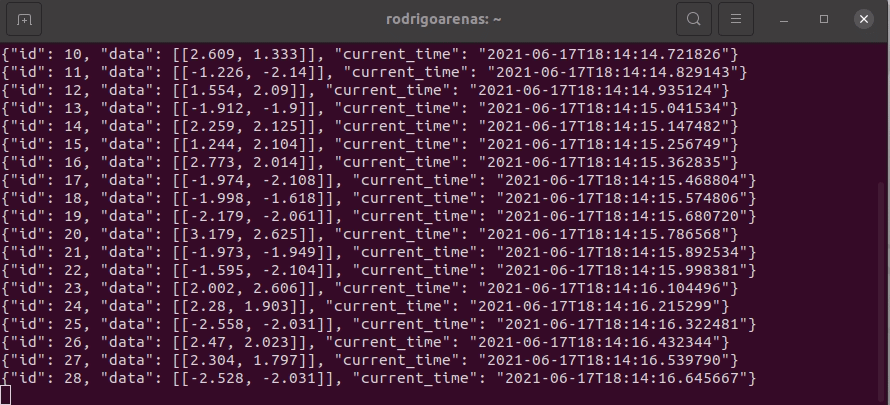
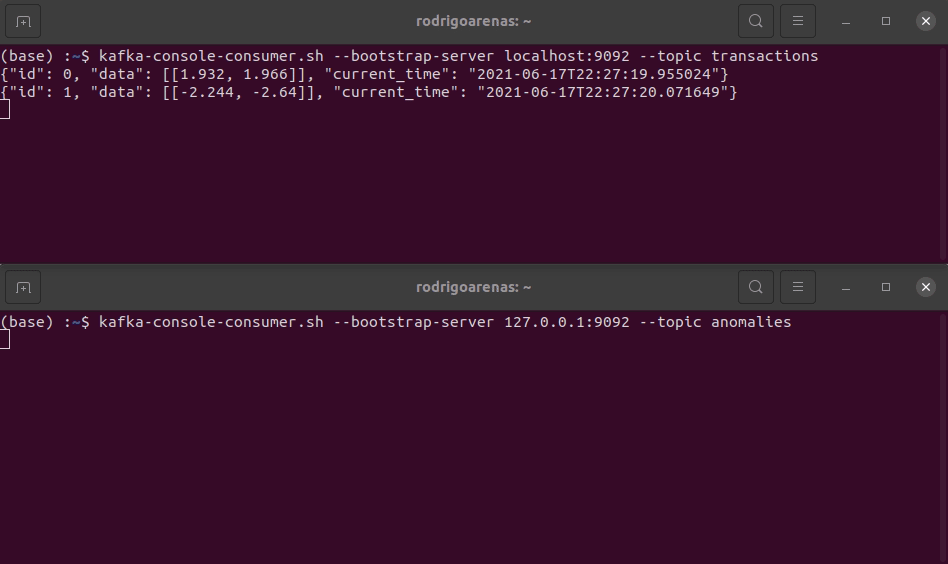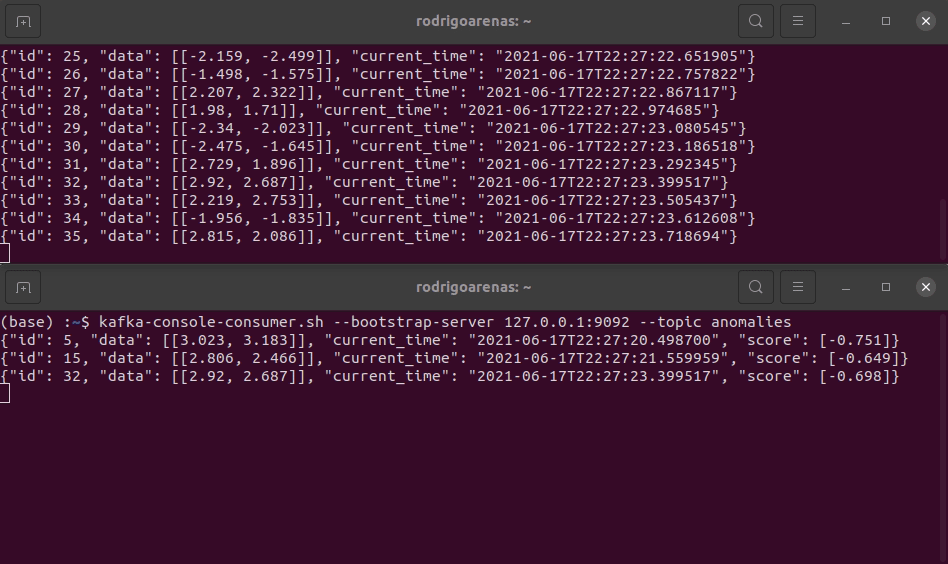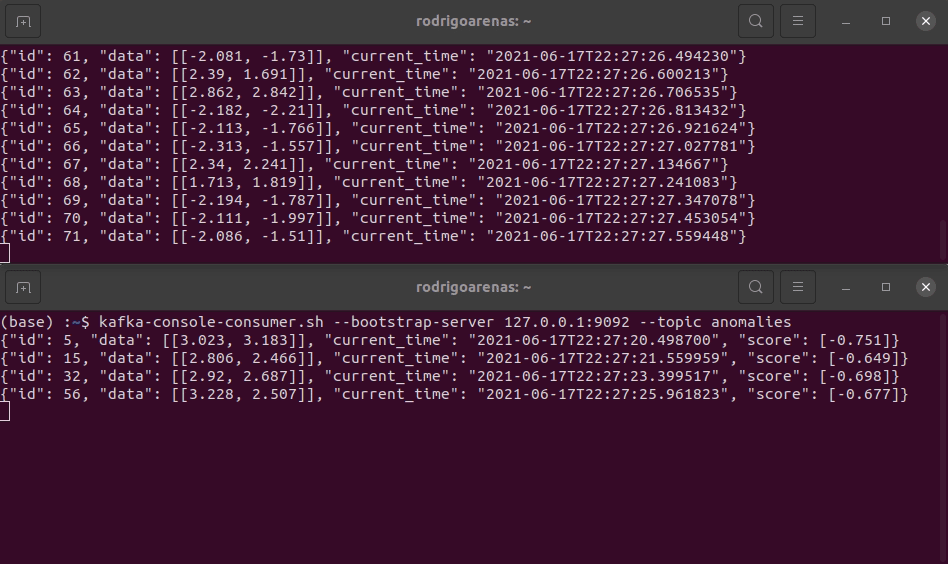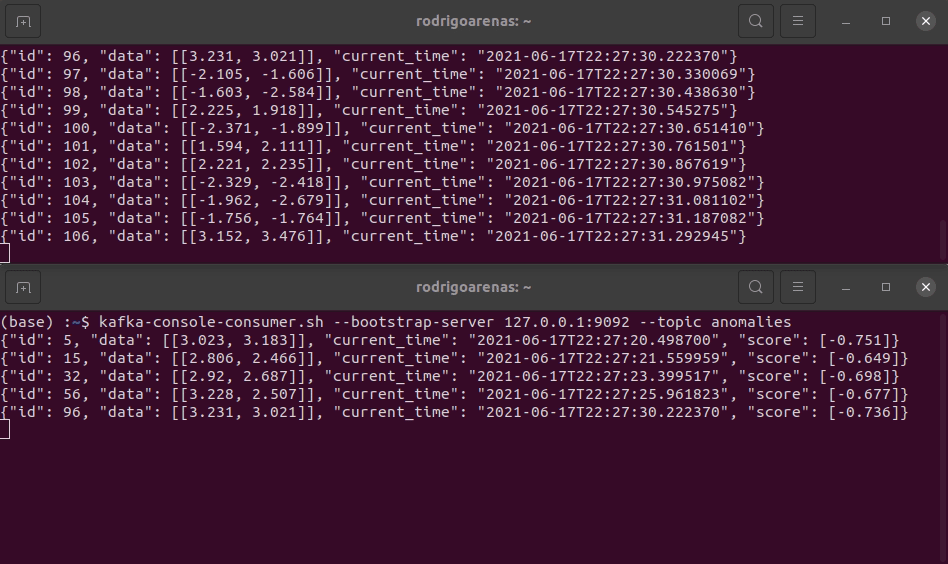
El repositorio original conserva la demostración que inspiró el artículo. El ejemplo de esta página fija versiones, usa Kafka en modo KRaft, valida mensajes y limita la ejecución. Sus scripts incluyen cambios respecto a los del repositorio. Las imágenes siguientes pertenecen a aquella demostración original.
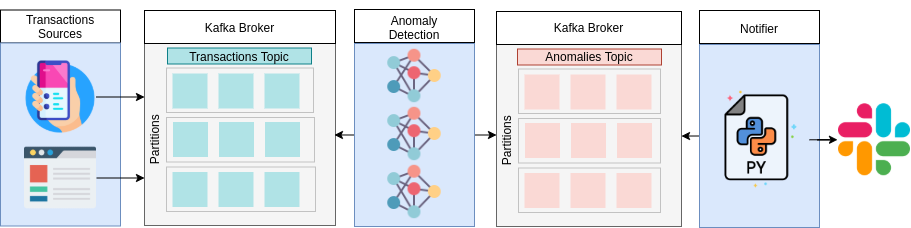
Entorno local y topics con tres particiones
Las pruebas usan Windows, Python 3.13.5 y las dependencias directas fijadas abajo. El cliente se instaló en un directorio aislado junto a las otras dependencias del entorno existente; no se comprobó una instalación nueva del entorno virtual ni un lock transitivo. Los comandos de Python usan el ejecutable de Windows; en Linux o macOS cambia esa ruta por .venv/bin/python.
Guarda lo siguiente en compose.yaml. Kafka 4.3.1 ejecuta broker y controlador KRaft en un único contenedor, sin ZooKeeper. El puerto publicado queda ligado a la máquina local. Esta configuración usa PLAINTEXT, una réplica y recursos limitados para la demo; un servicio productivo requiere una configuración de autenticación, disponibilidad y capacidad propia. Imagen oficial de Apache Kafka.
# compose.yaml
services:
  kafka:
    image: apache/kafka:4.3.1
    ports:
      - "127.0.0.1:9092:9092"
    environment:
      KAFKA_HEAP_OPTS: "-Xms256m -Xmx256m"
      KAFKA_AUTO_CREATE_TOPICS_ENABLE: "false"
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: "broker,controller"
      KAFKA_LISTENERS: "PLAINTEXT://:9092,CONTROLLER://:9093"
      KAFKA_ADVERTISED_LISTENERS: "PLAINTEXT://127.0.0.1:9092"
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: "CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT"
      KAFKA_CONTROLLER_LISTENER_NAMES: "CONTROLLER"
      KAFKA_CONTROLLER_QUORUM_VOTERS: "1@localhost:9093"
      KAFKA_INTER_BROKER_LISTENER_NAME: "PLAINTEXT"
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 1
      KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 1
    mem_limit: 768m
    cpus: 1.0
python -m venv .venv
.\.venv\Scripts\python.exe -m pip install `
    confluent-kafka==2.16.0 scikit-learn==1.9.0 numpy==2.4.6 joblib==1.5.3
New-Item -ItemType Directory -Force model, streaming
docker compose up -d
Espera a que Kafka termine de arrancar y crea explícitamente ambos topics. Cada comando debe terminar correctamente; si el broker aún no está listo, revisa docker compose logs kafka antes de continuar. La salida de --describe debe mostrar tres particiones. La creación automática de topics está deshabilitada.
docker compose exec kafka /opt/kafka/bin/kafka-topics.sh `
    --bootstrap-server localhost:9092 --create --topic transactions `
    --partitions 3 --replication-factor 1
docker compose exec kafka /opt/kafka/bin/kafka-topics.sh `
    --bootstrap-server localhost:9092 --create --topic anomalies `
    --partitions 3 --replication-factor 1
docker compose exec kafka /opt/kafka/bin/kafka-topics.sh `
    --bootstrap-server localhost:9092 --describe --topic transactions
Una partición es una secuencia ordenada de mensajes y cada mensaje tiene un offset dentro de ella. Kafka reparte las particiones de un topic entre los consumidores de un mismo grupo. Tres consumidores pueden trabajar sobre estas tres particiones; añadir consumidores por encima de ese número deja miembros sin partición asignada. La asignación puede cambiar durante un rebalanceo: no se fija una partición a cada hilo por su índice.
Entrenar y guardar el modelo
Guarda este script en model/train.py. Genera 1.000 observaciones de dos clusters gaussianos y guarda el modelo junto al script, en la ruta que después usará el detector. contamination=0.01 fija un umbral a partir del conjunto de entrenamiento; no mide la proporción real de fraude ni convierte el score en una probabilidad.
# model/train.py
from pathlib import Path

import numpy as np
from joblib import dump
from sklearn.ensemble import IsolationForest

rng = np.random.RandomState(42)
cluster = 0.3 * rng.randn(500, 2)
training = np.round(np.r_[cluster + 2, cluster - 2], 3)
model = IsolationForest(
    n_estimators=50, max_samples=500, random_state=42,
    contamination=0.01, n_jobs=1,
)
model.fit(training)
model_path = Path(__file__).resolve().parent / "isolation_forest.joblib"
dump(model, model_path)
print("Model saved:", model_path)
El artefacto joblib puede ejecutar código al cargarse. Esta demo carga únicamente el modelo que acabas de crear en una carpeta de confianza y con versiones compatibles. No cargues archivos recibidos de una fuente desconocida. Para evaluar calidad, necesitas datos representativos y una evaluación independiente del umbral y de los errores de detección.
Compartir envío confirmado y validación del evento
Guarda streaming/kafka_io.py. Los otros dos scripts importan este módulo. Cada envío espera su callback de entrega y falla si Kafka no lo confirma en el plazo indicado. Se usa envío por evento para hacer visible la confirmación, sin medir ni prometer rendimiento de streaming.
El consumidor admite un objeto JSON de hasta 4 KiB con un ID y exactamente una fila de dos números finitos representables como float32. Una entrada inválida produce un error y permanece sin confirmar; la demo se detiene para que el operador corrija la fuente. Un pipeline que continúe ante datos inválidos necesita diseñar explícitamente su cuarentena y política de reintentos.
# streaming/kafka_io.py
import json
import math

import numpy as np
from confluent_kafka import KafkaException, Producer

BOOTSTRAP = "127.0.0.1:9092"
TRANSACTIONS_TOPIC = "transactions"
ANOMALIES_TOPIC = "anomalies"
PARTITIONS = 3


def make_producer():
    return Producer({
        "bootstrap.servers": BOOTSTRAP,
        "enable.idempotence": True,
        "delivery.timeout.ms": 5000,
    })


def publish(producer, topic, record, partition=-1):
    delivery = {}

    def acknowledged(error, message):
        delivery["error"] = error

    producer.produce(
        topic, key=record["id"],
        value=json.dumps(record, allow_nan=False).encode("utf-8"),
        partition=partition, on_delivery=acknowledged,
    )
    if producer.flush(5) or "error" not in delivery:
        raise TimeoutError("Event delivery was not confirmed.")
    if delivery["error"] is not None:
        raise KafkaException(delivery["error"])


def decode_event(payload):
    if not isinstance(payload, bytes) or len(payload) > 4096:
        raise ValueError("Expected a JSON event of at most 4096 bytes.")
    try:
        record = json.loads(payload.decode("utf-8"))
    except (UnicodeDecodeError, json.JSONDecodeError, RecursionError) as error:
        raise ValueError("Invalid event JSON.") from error
    if not isinstance(record, dict):
        raise ValueError("Expected an event object.")
    event_id = record.get("id")
    if not isinstance(event_id, str) or not 1 <= len(event_id) <= 80:
        raise ValueError("Expected a nonempty event id of at most 80 characters.")
    data = record.get("data")
    if not isinstance(data, list) or len(data) != 1:
        raise ValueError("Expected one observation.")
    row = data[0]
    if not isinstance(row, list) or len(row) != 2:
        raise ValueError("Expected two features.")
    limit = float(np.finfo(np.float32).max)
    for value in row:
        if type(value) not in (int, float) or abs(value) > limit or not math.isfinite(value):
            raise ValueError("Features must be finite numbers representable as float32.")
    return record, np.asarray(data, dtype=np.float64)
Publicar una muestra finita
Guarda streaming/producer.py. Envía 60 eventos, distribuidos entre las tres particiones, con un ID distinto por lote y un timestamp UTC. La rama uniforme se elige con probabilidad 0,05; algunos de esos puntos pueden parecer normales al modelo. Tampoco se presupone que todos los puntos gaussianos se clasifiquen como normales.
# streaming/producer.py
from datetime import datetime, timezone
from uuid import uuid4
import time

import numpy as np
from kafka_io import PARTITIONS, TRANSACTIONS_TOPIC, make_producer, publish


def produce_events(count=60):
    rng = np.random.default_rng(42)
    batch = uuid4().hex
    with make_producer() as producer:
        for index in range(count):
            if rng.random() < 0.05:
                observation = rng.uniform(-4, 4, size=2)
            else:
                observation = 0.3 * rng.normal(size=2) + rng.choice([-2, 2])
            record = {
                "id": f"{batch}-{index}",
                "data": [np.round(observation, 3).tolist()],
                "current_time": datetime.now(timezone.utc).isoformat(),
            }
            publish(producer, TRANSACTIONS_TOPIC, record, partition=index % PARTITIONS)
            print("SENT", record["id"], flush=True)
            time.sleep(0.1)


if __name__ == "__main__":
    produce_events()
Detectar y confirmar después de procesar
Guarda streaming/anomalies_detector.py. Cada hilo crea su propio consumidor y productor; los tres consumidores comparten el grupo. Se deshabilitan el commit automático y el almacenamiento automático del offset. Para una anomalía, primero se espera la confirmación de su publicación y después se confirma el offset de entrada. Para un evento normal se confirma tras la evaluación. Antes de suscribirse, cada consumidor comprueba la conexión y las tres particiones con un plazo de cinco segundos. Esta demo interrumpe el consumo ante un error global recibido del cliente, aunque Kafka podría reintentarlo; también propaga errores de entrega, entrada y commit. Los contextos cierran los clientes y el evento de parada finaliza los otros hilos.
# streaming/anomalies_detector.py
from concurrent.futures import ThreadPoolExecutor, as_completed
from pathlib import Path
from threading import Event
import time

from joblib import load
from confluent_kafka import Consumer, KafkaException
from kafka_io import (
    ANOMALIES_TOPIC, BOOTSTRAP, PARTITIONS, TRANSACTIONS_TOPIC,
    decode_event, make_producer, publish,
)

model_path = Path(__file__).resolve().parents[1] / "model/isolation_forest.joblib"


def detect(stop, seconds=30, group_id="anomaly-detector-group"):
    model = load(model_path)
    errors = []
    config = {
        "bootstrap.servers": BOOTSTRAP,
        "group.id": group_id,
        "auto.offset.reset": "earliest",
        "enable.auto.commit": False,
        "enable.auto.offset.store": False,
        "allow.auto.create.topics": False,
        "socket.timeout.ms": 5000,
        "error_cb": errors.append,
    }
    with Consumer(config) as consumer:
        metadata = consumer.list_topics(topic=TRANSACTIONS_TOPIC, timeout=5)
        topic = metadata.topics[TRANSACTIONS_TOPIC]
        if topic.error is not None:
            raise KafkaException(topic.error)
        if len(topic.partitions) != PARTITIONS:
            raise ValueError("Create the input topic with three partitions first")
        with make_producer() as producer:
            consumer.subscribe([TRANSACTIONS_TOPIC])
            deadline = time.monotonic() + seconds
            while not stop.is_set() and time.monotonic() < deadline:
                message = consumer.poll(1)
                if errors:
                    raise KafkaException(errors[0])
                if message is None:
                    continue
                if message.error():
                    raise KafkaException(message.error())
                record, data = decode_event(message.value())
                if model.predict(data)[0] == -1:
                    record["score"] = float(model.score_samples(data)[0])
                    publish(producer, ANOMALIES_TOPIC, record)
                    print("ANOMALY", record["id"], record["score"], flush=True)
                committed = consumer.commit(message=message, asynchronous=False)
                for partition in committed:
                    if partition.error is not None:
                        raise KafkaException(partition.error)


def run(seconds=30):
    stop = Event()
    with ThreadPoolExecutor(max_workers=PARTITIONS) as workers:
        futures = [workers.submit(detect, stop, seconds) for _ in range(PARTITIONS)]
        try:
            for future in as_completed(futures):
                future.result()
        finally:
            stop.set()


if __name__ == "__main__":
    run()
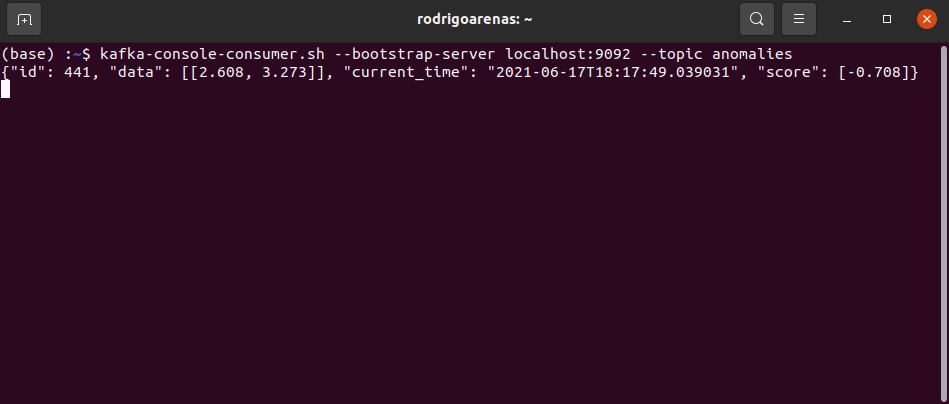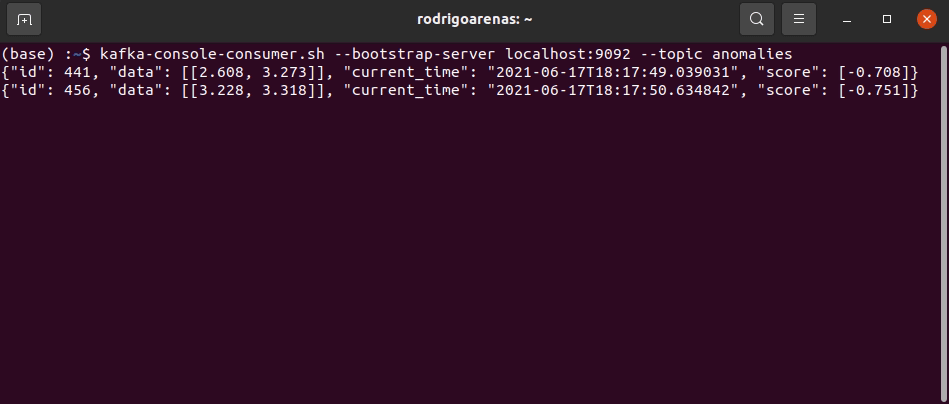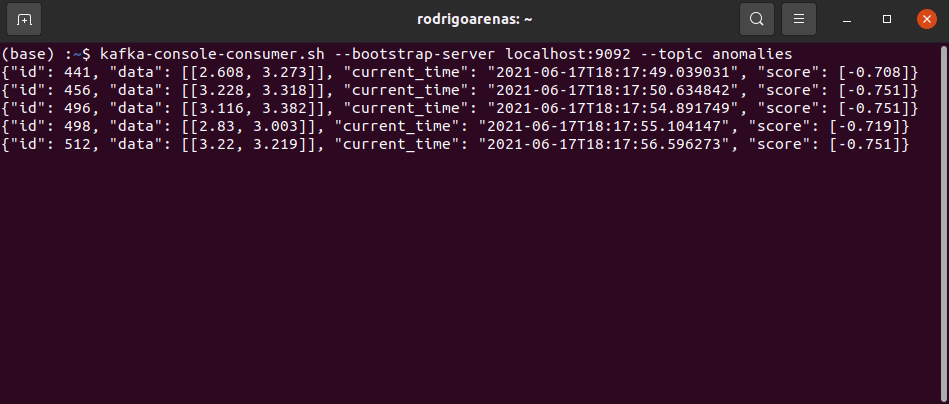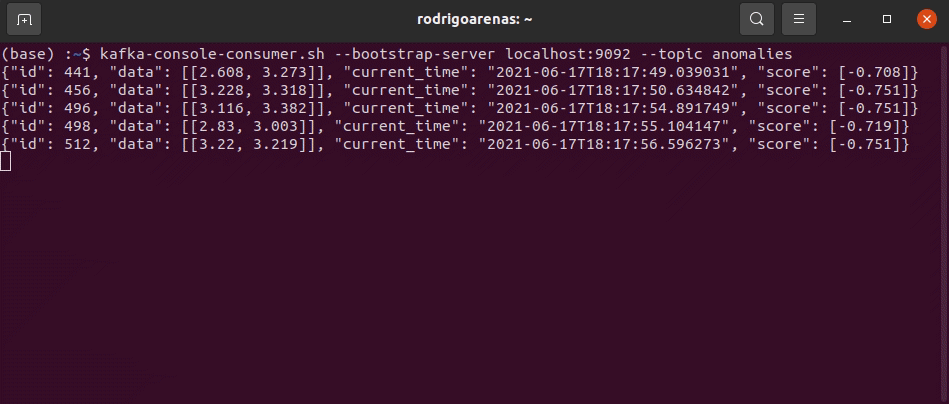
Si el proceso falla después de publicar una anomalía y antes del commit, el mensaje de entrada puede reaparecer y producir otra copia en la salida. El ID se conserva para que un consumidor posterior pueda identificar duplicados; este ejemplo no implementa deduplicación persistente ni una transacción entre los dos topics. La idempotencia del productor no elimina duplicados causados por reprocesar una entrada. Offsets y garantías del cliente Python.
Ejecutar, inspeccionar y cerrar
Después de crear los cuatro archivos, entrena primero. En dos terminales de la misma carpeta, inicia el detector y enseguida el productor. Cada consumidor procesa durante 30 segundos después de comprobar la conexión; el arranque y el cierre añaden tiempo. Si inicias tarde el productor, vuelve a ejecutar el detector para procesar los mensajes pendientes. El productor termina después de sus 60 eventos. El detector también termina por su plazo o por un error; Ctrl+C activa el cierre de los hilos. La consola muestra SENT para entregas confirmadas y ANOMALY con el ID y score de cada detección publicada.
# First train the model from the project folder.
.\.venv\Scripts\python.exe model/train.py

# Terminal 1: three consumers; each processes for 30 seconds after startup.
.\.venv\Scripts\python.exe streaming/anomalies_detector.py

# Terminal 2: publish 60 events while the detector is running.
.\.venv\Scripts\python.exe streaming/producer.py
Revisa los mensajes de salida y detén el broker al terminar. El consumidor de consola sale cuando expira el timeout sin mensajes; ese timeout no es una prueba de que hubiera anomalías. La demo no mide latencia de extremo a extremo, capacidad de producción ni calidad sobre datos reales.
docker compose exec kafka /opt/kafka/bin/kafka-console-consumer.sh `
    --bootstrap-server localhost:9092 --topic anomalies --from-beginning `
    --timeout-ms 5000
docker compose down
Para servir el modelo bajo petición, continúa con FastAPI y Docker. Para revisar cambios en los datos y en los resultados del modelo, consulta monitoreo con Evidently.
¿Vas a construir una plataforma de IA o de datos?
Si necesitas adaptar este enfoque a tu sistema, cuéntame qué datos tienes y qué decisión técnica necesitas resolver.