Artículos / LLMs & Agents
Enrutamiento de intenciones tipado en Python con Jev y TypeSafe
Enruta solicitudes hacia manejadores deterministas, un LLM o revisión humana con respuestas tipadas Choice y Noul de Jev en Python.
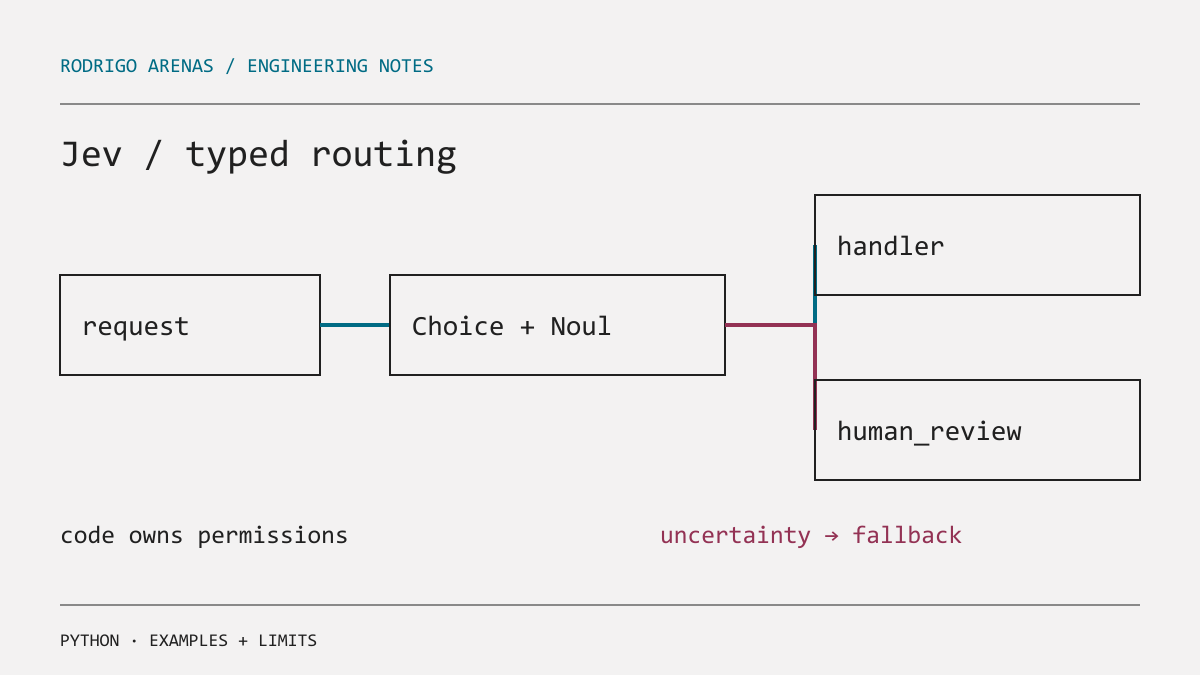
Un agente que manda cada mensaje al mismo modelo generalista no tiene una política de enrutamiento explícita. Una solicitud para cancelar una suscripción, una pregunta factual y una queja ambigua entran al mismo prompt. Luego es difícil probar qué ruta se ejecutó y automatizar acciones de impacto se vuelve riesgoso.
El enrutamiento tipado separa dos trabajos. El código posee los manejadores disponibles y sus permisos. Un juicio acotado del modelo elige uno de ellos y expone incertidumbre para que la política la gestione. Jev, el modelo System One de TypeSafe, está pensado para esa segunda parte: devuelve decisiones estructuradas y no una respuesta abierta.
Este artículo construye un enrutador pequeño en Python. La función siguiente es una frontera de integración: cuando quien la llama entregue un ID verificado, texto redactado, typesafe-sdk y TYPESAFE_API_KEY, su llamada realiza la solicitud al SDK.
Empieza con rutas que el código pueda imponer
No permitas que un modelo invente nombres de rutas. Define un conjunto cerrado cuyas consecuencias sean claras:
| Ruta | Lo que el código puede hacer |
|---|---|
help_center | Buscar documentación de solo lectura |
account_status | Consultar el estado del usuario autenticado |
cancellation_request | Recoger intención y exigir una confirmación separada |
human_review | Crear una tarea de soporte sin cambiar la cuenta |
La ruta de cancelación no es una operación de cancelación. Una clasificación puede fallar y una salida tipada solo garantiza la interfaz, no que el modelo entendió autoridad o intención. Verifica autenticación, muestra la consecuencia y consigue confirmación con código normal de la aplicación.
Formula una decisión y una pregunta independiente de aclaración
El inicio rápido del SDK Python de TypeSafe actual instala typesafe-sdk y expone TypeSafeClient, Choice, Noul y Score. Choice elige entre criterios definidos; Noul devuelve la probabilidad de sí. Este ejemplo completo pregunta ambas cosas sobre el mismo estado.
from typesafe_sdk import Choice, Noul, TypeSafeClient


def clasificar_solicitud(mensaje_redactado: str, usuario_id_verificado: str) -> tuple[str, float, float]:
    estado = {
        "message": mensaje_redactado,
        "user": {"id": usuario_id_verificado},
    }
    preguntas = {
        "route": Choice(
            instructions=(
                "Elige el siguiente flujo de soporte. Elige human_review si el "
                "mensaje es ambiguo o necesita a una persona."
            ),
            criteria={
                "help_center": "Pregunta respondible con ayuda pública.",
                "account_status": "Pregunta por el estado actual de su cuenta.",
                "cancellation_request": "Quiere cancelar o cerrar una cuenta.",
                "human_review": "Ambigua, sensible o fuera de estos flujos.",
            },
        ),
        "needs_clarification": Noul(
            instructions=(
                "¿Esta solicitud contiene varias intenciones sin resolver o carece "
                "del detalle necesario para elegir un flujo seguro?"
            )
        ),
    }

    with TypeSafeClient() as client:
        result = client.system_one(state=estado, questions=preguntas)

    ruta = result.choices["route"]
    aclaracion = result.nouls["needs_clarification"]
    return ruta.choice, ruta.confidence, aclaracion.noul
ruta.choice es la etiqueta seleccionada y ruta.confidence mide qué tan concentrada está esa elección frente a las alternativas. El valor Noul es la probabilidad entre 0 y 1 de que la solicitud requiera aclaración. Responden preguntas distintas, por lo que no debes compararlos como una puntuación de seguridad universal. La guía de confianza hace esta misma distinción.
La redacción ocurre antes de esta función. No envíes un mensaje crudo para preguntar si contiene secretos. Quien la llama debe autenticar la sesión, retirar credenciales y datos de pago según su política, y pasar solo el texto mínimo para enrutar. El nombre usuario_id_verificado documenta una precondición; el SDK no puede verificarla.
Coloca umbrales y efectos secundarios en Python
Los umbrales pertenecen a la aplicación porque el costo del error depende de la acción. Una búsqueda de ayuda con baja confianza puede ser inocua. Una cancelación con baja confianza nunca debe cambiar estado. Esta capa de política consume la salida anterior:
def elegir_manejador(ruta: str, confianza: float, probabilidad_aclaracion: float) -> str:
    if probabilidad_aclaracion >= 0.6:
        return "ask_clarifying_question"
    if confianza < 0.80:
        return "human_review"
    if ruta == "cancellation_request":
        return "show_cancellation_confirmation"
    return ruta
Los valores numéricos son hipótesis iniciales, no garantías del modelo. Elígelos con mensajes etiquetados representativos y el costo real de una ruta equivocada. Guarda ruta, confianza, resultado de política y etiqueta de evaluación que no exponga datos privados. No guardes secretos sin ocultar para depurar el clasificador.
Prueba el flujo, no solo el clasificador
Crea una tabla versionada con texto de solicitud ya redactado, ruta esperada, resultado de política esperado y si requiere aclaración. Incluye español e inglés, errores tipográficos, casos límite y mensajes con varias intenciones. Una ruta puede ser correcta mientras el manejador falla, así que prueba ambas capas.
Por ejemplo, "Quiero borrar mi cuenta, pero primero envíame mi factura" puede requerir revisión en vez de forzar una sola ruta. A veces el resultado correcto es escalar, no una predicción más segura. Mide acuerdo por clase, proporción escalada y tasa de resultados automáticos inseguros. La guía de evaluación de agentes de Anthropic también propone evaluar tareas y calificadores contra el comportamiento que el sistema debe producir.
Dónde encaja en un agente
Usa el enrutamiento antes de decidir qué conjunto acotado de herramientas puede ver un agente. Una pregunta de consulta de solo lectura puede ir a RAG. Una pregunta de cuenta puede recibir una consulta limitada. Una solicitud ambigua debe llegar a una persona o a una aclaración, no a un prompt más grande con más herramientas. Complementa el ciclo descrito en Agentes de IA con LangGraph para análisis de datos: LangGraph coordina un flujo y el enrutamiento tipado hace observable y comprobable la rama inicial.
Jev no sustituye autorización, validación de entradas, registros de auditoría ni una pantalla de confirmación. Es útil cuando el código no puede interpretar lenguaje natural de forma fiable, pero sí puede imponer lo que cada interpretación está autorizada a hacer.
Sobre el autor
Rodrigo Arenas es arquitecto de software e ingeniero de machine learning en Medellín, Colombia. Construye productos, plataformas y software open source para IA, Data Engineering y Machine Learning: es el creador de Ciaren, sklearn-genetic-opt y PyWorkforce.
¿Vas a construir una plataforma de IA o de datos?
Diseño y construyo sistemas críticos de principio a fin: arquitectura, datos, modelos y producto. Si esa es la escala en la que trabajas, hablemos.