Artículos / LLMs & Agents
Evalúa RAG offline: recuperación y disponibilidad de evidencia
Usa un arnés pequeño y ejecutable en Python para medir recuperación y disponibilidad de evidencia anotada antes de cambiar un sistema RAG.
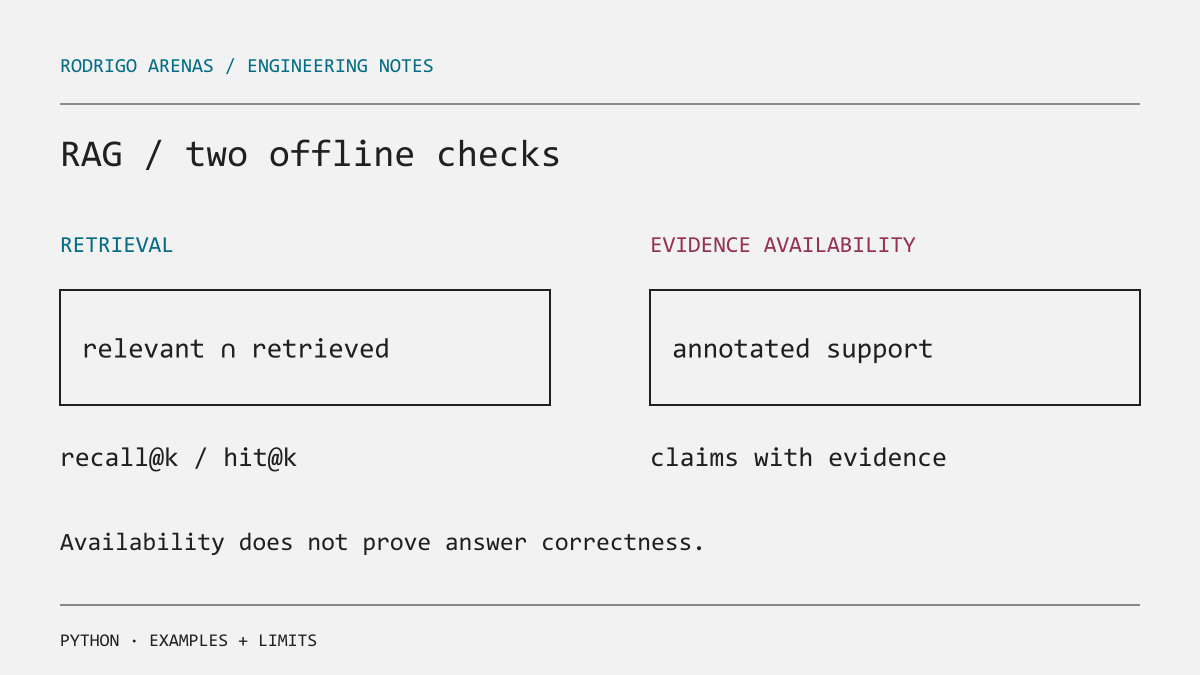
Una respuesta RAG puede ser fluida y errónea de dos maneras distintas. El recuperador puede no traer la evidencia, o la evidencia puede estar presente y el generador aun así añadir una afirmación sin respaldo. Una sola puntuación de calidad oculta esa diferencia y dirige la depuración al prompt cuando el índice es el problema real.
Este artículo define dos mediciones offline que no requieren llamada a modelo: recall de recuperación y disponibilidad de evidencia anotada por personas. Son sencillas a propósito. Ofrecen una línea base reproducible para detectar regresiones antes de cambiar embeddings, reranker, chunking o prompt. Para el pipeline, consulta Cómo construir un sistema RAG con LangChain y Python; aquí construimos la capa de evaluación.
Haz que los casos de prueba sean inspeccionables
Cada caso requiere pregunta, uno o más IDs de fragmentos relevantes y afirmaciones de una respuesta candidata con IDs de respaldo verificados por una persona. Mantén los IDs estables durante una ejecución. Si un experimento de chunking los cambia, conserva un mapa o vuelve a anotar con intención, no compares etiquetas incompatibles.
from dataclasses import dataclass


@dataclass(frozen=True)
class Caso:
    pregunta: str
    ids_fragmentos_relevantes: set[str]
    afirmaciones_respuesta: list[tuple[str, set[str]]]


CASO = Caso(
    pregunta="¿Cuántos días de vacaciones pasan al siguiente año?",
    ids_fragmentos_relevantes={"politica-ausencias-2026-1", "politica-ausencias-2026-4"},
    afirmaciones_respuesta=[
        ("Las personas pueden pasar cinco días sin usar.", {"politica-ausencias-2026-4"}),
        ("La política aplica al año del plan 2026.", {"politica-ausencias-2026-1"}),
    ],
)
Las dos afirmaciones son una respuesta candidata con anotaciones de respaldo, no respuestas esperadas contradictorias. Una respuesta de referencia no debe ser un guion que el modelo copie. Anota unidades factuales importantes y haz que una persona verifique los pasajes que sustentan cada una antes de usar las etiquetas.
Mide recuperación antes de calidad de respuesta
Recall en k es la proporción de fragmentos relevantes entre los primeros k resultados. Hit rate en k pregunta únicamente si llegó al menos uno. El rango recíproco medio premia que el primer fragmento relevante esté arriba. Los casos sin fragmentos relevantes son casos de abstención, por eso las funciones devuelven None y deben reportarse separados, no promediarse dentro de recall.
def recall_en_k(recuperados: list[str], relevantes: set[str], k: int) -> float | None:
    if not relevantes:
        return None
    if k <= 0:
        return 0.0
    return len(set(recuperados[:k]) & relevantes) / len(relevantes)


def hit_en_k(recuperados: list[str], relevantes: set[str], k: int) -> float | None:
    if not relevantes:
        return None
    if k <= 0:
        return 0.0
    return float(bool(set(recuperados[:k]) & relevantes))


def rango_reciproco(recuperados: list[str], relevantes: set[str]) -> float:
    for posicion, fragmento_id in enumerate(recuperados, start=1):
        if fragmento_id in relevantes:
            return 1.0 / posicion
    return 0.0
Para relevantes={"a", "b"}, un top cinco con solo a tiene recall de 0.5 y hit rate de 1.0. Conviene informar ambos. Recall indica que falta evidencia necesaria; hit rate indica que la búsqueda encontró algo.
No subas k silenciosamente hasta que recall se vea bien. Más contexto puede diluir la respuesta, gastar presupuesto y esconder un fallo de ranking. Compara configuraciones fijas como top 3 y top 5, luego inspecciona fallos por tipo de documento, fecha, fraseo de consulta y filtro de metadatos.
Mide disponibilidad de evidencia anotada, no fidelidad
El siguiente ejemplo offline usa anotaciones afirmación-fragmento verificadas por personas en vez de un LLM como juez. Mide si el conjunto recuperado contiene evidencia ya etiquetada para una afirmación candidata. No establece que una respuesta generada sea verdadera, esté bien citada ni sea fiel. Un modelo puede citar una fuente disponible y tergiversarla. Una persona o un juez de soporte calibrado debe etiquetar la afirmación generada contra el pasaje antes de llamarlo métrica de fidelidad.
def disponibilidad_evidencia_afirmacion(
    afirmaciones: list[tuple[str, set[str]]], recuperados: list[str]
) -> float:
    if not afirmaciones:
        return 1.0
    disponibles = set(recuperados)
    con_soporte = sum(bool(fuentes & disponibles) for _, fuentes in afirmaciones)
    return con_soporte / len(afirmaciones)


recuperados = ["politica-ausencias-2026-4", "beneficios-2"]
print(recall_en_k(recuperados, CASO.ids_fragmentos_relevantes, k=2))
print(hit_en_k(recuperados, CASO.ids_fragmentos_relevantes, k=2))
print(disponibilidad_evidencia_afirmacion(CASO.afirmaciones_respuesta, recuperados))
Esto imprime 0.5, 1.0 y 0.5. La recuperación encontró alguna evidencia con respuesta, pero no evidencia para la afirmación candidata sobre año del plan. Es disponibilidad de evidencia, no un veredicto de fidelidad. Una respuesta generada aún necesita revisión de soporte por afirmación; antes de generarla, el sistema debe recuperar evidencia faltante u omitir la afirmación.
Añade abstenciones y compuertas de cambio
Incluye preguntas que el corpus no pueda responder. El comportamiento esperado es abstenerse, pedir aclaración o indicar una limitación. En ellas la calidad de recuperación no basta porque la búsqueda vectorial siempre devuelve vecinos. Registra si el sistema afirmó algo sin respaldo y si mostró fuentes que la persona pueda comprobar.
Usa una partición fija de evaluación para decisiones de cambio y otra de desarrollo para ajuste. Establece línea base por métrica y rechaza un cambio que reduzca materialmente recall o disponibilidad de evidencia anotada aunque mejore un agregado. El umbral depende del daño, mezcla de tráfico y capacidad de revisión. Una puntuación offline nunca garantiza producción.
Las evaluaciones de agentes necesitan la misma disciplina. La guía de Anthropic sobre evaluaciones de agentes recomienda resultados específicos de tarea y calificadores fiables. En RAG el diagnóstico suele ser: ¿llegó la evidencia y la respuesta se mantuvo dentro de ella? Separar esas preguntas vuelve depurables las regresiones.
Sobre el autor
Rodrigo Arenas es arquitecto de software e ingeniero de machine learning en Medellín, Colombia. Construye productos, plataformas y software open source para IA, Data Engineering y Machine Learning: es el creador de Ciaren, sklearn-genetic-opt y PyWorkforce.
¿Vas a construir una plataforma de IA o de datos?
Diseño y construyo sistemas críticos de principio a fin: arquitectura, datos, modelos y producto. Si esa es la escala en la que trabajas, hablemos.