
Artículos / LLMs & Agents
Extracción de productos con LLMs: valida las variantes antes de importar
Valida datos de productos extraídos con LLMs en Python: vincula cada campo al SKU correcto, conserva precios desconocidos y rechaza evidencia de otra variante.
El vaso azul cuesta 24,90 dólares. El rojo, 19,90. Un extractor devuelve el vaso azul con el precio del rojo: el JSON es válido y la cita aparece en la página. Cada campo parece razonable. El registro sigue estando mal.
Al extraer datos de productos, valida la variante antes de importar los campos. Vincula el SKU solicitado a una captura de la fuente y comprueba cada valor contra la evidencia de ese registro. Un esquema detecta una salida mal formada; no sabe si el precio pertenece al vaso azul.
Este tutorial implementa esa comprobación después de la respuesta de un LLM. Usa un catálogo ficticio y un candidato ya preparado: puedes probar los errores sin una clave de API. Para realizar la llamada al modelo, consulta primero extracción estructurada con Python y Pydantic.
Decide qué representa cada registro
Una familia de productos y una variante no son la misma unidad de datos. La descripción puede servir para todos los vasos, mientras que el precio o la disponibilidad corresponden a un SKU. ProductGroup de Schema.org representa una familia cuyos productos varían por propiedades como color o talla. La distinción también sirve cuando el destino es un CSV.
| Situación en la fuente | Decisión de importación | Error que evita |
|---|---|---|
| Aparecen las variantes azul y roja | Seleccionar el SKU antes de validar | Tomar el precio más bajo de la página |
El precio dice explícitamente 0.00 | Aceptarlo si coincide con la evidencia | Confundir cero con un dato ausente |
| No aparece el precio | Mantenerlo desconocido y pedir revisión | Sustituirlo por cero |
| Cambia la moneda o el formato | Usar otro perfil de lectura explícito | Adivinar qué significa una coma |
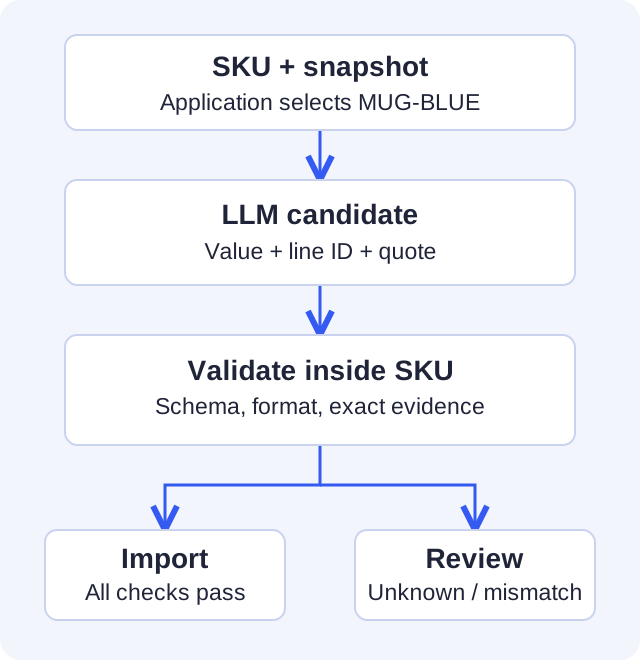
La aplicación elige expected_sku; el modelo no elige contra qué registro se le valida. En un importador real, conserva la URL, la fecha de captura y el identificador de la instantánea junto al trabajo. Aquí solo guardamos las líneas capturadas: no implementamos un rastreador, controles de antigüedad ni sincronización de existencias.
Exige evidencia y permite declarar lo desconocido
El ejemplo usa Python 3.13 y Pydantic 2.13.4. Guarda los tres bloques de Python siguientes, en orden, en validate_product.py:
py -3.13 -m venv .venv
& .\.venv\Scripts\python.exe -m pip install pydantic==2.13.4
& .\.venv\Scripts\python.exe validate_product.py
import re
from pydantic import BaseModel, ConfigDict, Field, ValidationError


class Evidence(BaseModel):
    model_config = ConfigDict(strict=True, extra="forbid")
    value: str = Field(min_length=1, max_length=200)
    line_id: str = Field(min_length=1, max_length=40)
    quote: str = Field(min_length=1, max_length=240)


class ProductCandidate(BaseModel):
    model_config = ConfigDict(strict=True, extra="forbid")
    sku: str = Field(min_length=1, max_length=64)
    title: Evidence
    color: Evidence
    price: Evidence | None


class ReviewRequired(ValueError):
    pass
price debe aparecer, pero puede valer None. Omitirlo incumple el esquema; devolver None declara que no se extrajo un precio. Ninguno de los dos casos se convierte en cero. En Pydantic, aceptar un valor nulo no crea un valor predeterminado. Valores predeterminados de los campos.
Todos los valores de evidencia son texto. El modo estricto rechaza el número 24.90 si el contrato pide una cadena; extra="forbid" rechaza claves inesperadas. Son comprobaciones distintas de las que haremos contra la fuente. Configuración de Pydantic.
Comprueba los campos dentro de la variante elegida
El formato admitido es deliberadamente pequeño: tres líneas etiquetadas, precio en USD, punto decimal y dos decimales. Los valores deben coincidir exactamente. No hay coincidencia aproximada ni conversión automática de moneda.
def validate_product(payload: dict, expected_sku: str,
                     snapshot: dict[str, dict[str, str]]) -> dict[str, str]:
    candidate = ProductCandidate.model_validate(payload)
    if candidate.sku != expected_sku:
        raise ReviewRequired("Candidate belongs to another SKU")
    source = snapshot.get(expected_sku)
    if source is None:
        raise ReviewRequired("No captured source for the requested SKU")
    if candidate.price is None:
        raise ReviewRequired("Price is unknown; do not replace it with zero")
    if not re.fullmatch(r"(?:0|[1-9][0-9]{0,8})\.[0-9]{2}", candidate.price.value):
        raise ReviewRequired("Unsupported USD price format")

    for evidence, label in [
        (candidate.title, "Title"), (candidate.color, "Color"),
        (candidate.price, "Price: USD"),
    ]:
        separator = " " if label == "Price: USD" else ": "
        expected_line = f"{label}{separator}{evidence.value}"
        if (source.get(evidence.line_id) != evidence.quote
                or evidence.quote != expected_line):
            raise ReviewRequired(f"{label}: value is not supported by this SKU")

    return {
        "sku": expected_sku, "title": candidate.title.value,
        "color": candidate.color.value, "currency": "USD",
        "price": candidate.price.value,
    }
La cita debe coincidir tanto con la línea capturada como con la etiqueta y el valor esperados. Una cita correcta unida a un valor inventado falla. El precio correcto de otro SKU también falla: la función solo consulta las líneas del registro seleccionado.
Esto garantiza coherencia dentro de este formato capturado. No demuestra que el comercio publicara el dato correcto, que la captura seleccionara bien la variante ni que el precio siga vigente. Esos controles pertenecen a la captura y a la operación del importador.
Prueba el registro correcto y cambia su precio
Estos datos son ejemplos ficticios, no respuestas medidas de un modelo:
SNAPSHOT = {
    "MUG-BLUE": {"l1": "Title: Travel mug", "l2": "Color: Blue",
                 "l3": "Price: USD 24.90"},
    "MUG-RED": {"l1": "Title: Travel mug", "l2": "Color: Red",
                "l3": "Price: USD 19.90"},
}
CANDIDATE = {
    "sku": "MUG-BLUE",
    "title": {"value": "Travel mug", "line_id": "l1", "quote": "Title: Travel mug"},
    "color": {"value": "Blue", "line_id": "l2", "quote": "Color: Blue"},
    "price": {"value": "24.90", "line_id": "l3", "quote": "Price: USD 24.90"},
}
print(validate_product(CANDIDATE, "MUG-BLUE", SNAPSHOT))

mixed_variant = {**CANDIDATE, "price": {
    "value": "19.90", "line_id": "l3", "quote": "Price: USD 19.90",
}}
try:
    validate_product(mixed_variant, "MUG-BLUE", SNAPSHOT)
except ReviewRequired as error:
    print("Review:", error)
La primera llamada devuelve el vaso azul con 24.90. La segunda imprime el motivo de revisión. La función no escribe en ningún catálogo: el código que la llama debe tratar ValidationError y ReviewRequired como resultados distintos e importar solo una devolución correcta. Mantén la captura independiente del candidato; si aceptas las líneas fuente propuestas por el mismo modelo, pierdes el valor de esta comprobación.
Conecta el modelo sin debilitar la validación
Entrega al extractor las líneas del SKU elegido, el esquema y una instrucción breve: cita la evidencia, usa null si no hay precio y no tomes valores de otra variante. Trata el texto fuente como datos, incluso si contiene instrucciones. El prompt orienta la respuesta; la función de Python hace cumplir el contrato de importación de este ejemplo.
Antes de ampliar el formato, etiqueta una muestra de capturas reales que tengas permiso para procesar. Mide por separado la tasa de variantes mezcladas, la precisión por campo y la proporción enviada a revisión. Incluye precios ausentes y cambios de variante: una colección de páginas limpias no revela esos fallos. Los ejemplos de este artículo no implican ningún porcentaje de precisión.
Para importes y conciliación de totales, consulta el ejemplo de validación de facturas. Si un registro necesita una decisión humana, puedes pausar el flujo con LangGraph antes de importarlo.
¿Vas a construir una plataforma de IA o de datos?
Si necesitas adaptar este enfoque a tu sistema, cuéntame qué datos tienes y qué decisión técnica necesitas resolver.