Artículos / LLMs & Agents
Ingeniería de contexto para agentes: RAG, memoria y resultados de herramientas
Elige qué ve un agente desde recuperación, memoria y resultados de herramientas con presupuestos explícitos de frescura, procedencia y tokens.
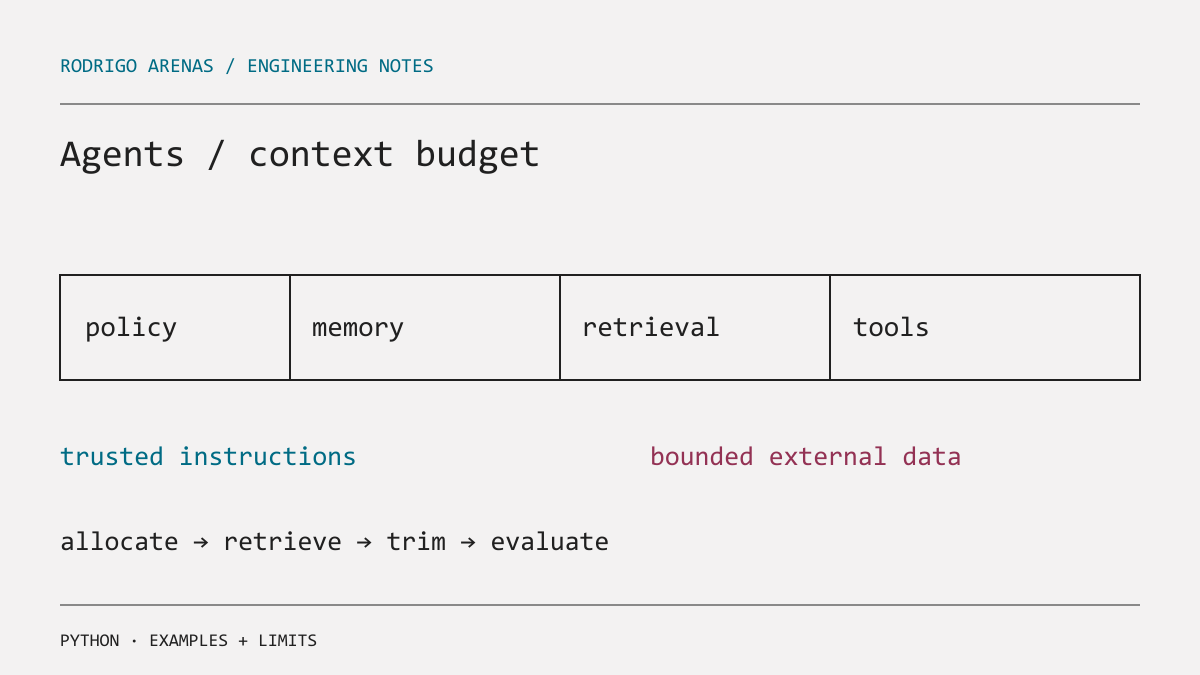
Un agente puede fallar mucho antes de elegir una mala herramienta. Falla cuando su contexto mezcla memoria obsoleta, recuperación irrelevante, resultados de herramientas sin límite e instrucciones de texto no confiable. La ingeniería de contexto decide, da forma y descarta esa información para que la siguiente llamada al modelo tenga evidencia utilizable.
RAG, memoria y resultados de herramientas no son formas intercambiables de contexto. Responden preguntas distintas:
| Fuente | Mejor para | Frescura | Fallo principal |
|---|---|---|---|
| RAG | Documentos y políticas estables | Depende del índice | No se recupera texto relevante |
| Memoria | Preferencias y decisiones previas | Debe expirar o corregirse | Una inferencia vieja se vuelve falso hecho |
| Resultado de herramienta | Estado actual o cálculo exacto | Normalmente por solicitud | Salida enorme, privada o con instrucciones |
El artículo de Anthropic sobre ingeniería de contexto plantea el objetivo como entregar el conjunto más pequeño de tokens con alta señal para el siguiente paso. Es una restricción práctica: contexto de más cuesta, oculta evidencia clave y ofrece más material para una inyección de prompt.
Da procedencia y presupuesto a cada elemento
Representa el contexto como registros antes de concatenar texto. Este ejemplo completo planifica de forma offline. Los conteos son estimados por palabras para ilustrar; para un límite real usa el tokenizador del modelo desplegado.
from dataclasses import dataclass
from datetime import datetime, timedelta


@dataclass(frozen=True)
class ElementoContexto:
    fuente: str
    texto: str
    observado_en: datetime
    confiable: bool
    tokens_estimados: int


def dentro_presupuesto(elementos: list[ElementoContexto], presupuesto: int) -> list[ElementoContexto]:
    elegidos: list[ElementoContexto] = []
    gastados = 0
    for elemento in elementos:
        if gastados + elemento.tokens_estimados <= presupuesto:
            elegidos.append(elemento)
            gastados += elemento.tokens_estimados
    return elegidos


def es_fresco(elemento: ElementoContexto, ahora: datetime) -> bool:
    if elemento.fuente == "tool":
        return ahora - elemento.observado_en <= timedelta(minutes=5)
    if elemento.fuente == "memory":
        return ahora - elemento.observado_en <= timedelta(days=30)
    return True  # Los documentos RAG necesitan versión y vigencia propias.
La marca confiable no debe significar que sea seguro obedecer como instrucción. Un ticket recuperado y una respuesta de API externa son datos. Ponlos en campos de evidencia delimitados, indica al modelo que no son confiables y nunca permitas que redefinan permisos de herramientas o política. En un sistema real, autorización, inquilino, versión documental y clasificación de datos pueden requerir campos separados.
Ordena según la siguiente decisión
Un orden de ensamblaje útil es:
- Política estable del sistema y herramientas permitidas, escritas por la aplicación.
- Objetivo actual de la persona y alcance autenticado.
- Resultado fresco y estrecho de la herramienta necesario para la próxima decisión.
- Pasajes recuperados para la pregunta actual, con IDs de fuente.
- Memoria compacta, relevante, atribuible y sin expirar.
No es una plantilla de prompt, es una política de selección. El total actual de una factura desde una herramienta debe superar un resumen de memoria sobre gasto; una política versionada ayer debe superar un resumen de chat de seis meses. Cuando las fuentes entren en conflicto, presenta el conflicto y consulta una herramienta o persona. No las mezcles en un párrafo aparentemente autoritativo.
Acota cada fuente en su frontera
RAG debe recuperar pocos candidatos, filtrar por acceso y metadatos, rerankear si la evaluación lo justifica y conservar IDs con extractos. La memoria debe guardar hechos breves como preferred_language=es con fuente y vencimiento, no cada transcripción. Los adaptadores de herramientas deben proyectar solo campos necesarios y limitar filas, páginas y bytes.
Por ejemplo, una consulta de pedido puede devolver order_id, status, updated_at y el campo solicitado. No debe devolver un registro de auditoría de 2.000 filas para que el modelo decida qué importa. Si hace falta detalle, expón una segunda herramienta de lectura acotada por order_id. Es la misma disciplina de capacidades de Construye un servidor MCP seguro de solo lectura en Python.
Planifica un presupuesto fijo para un turno con herramientas
Imagina que el agente tiene 6.000 tokens de entrada tras instrucciones de sistema. Resérvalos antes de llamar componentes:
| Segmento | Presupuesto | Política |
|---|---|---|
| Tarea y estado actual | 800 | Incluir siempre |
| Resultado reciente de herramienta | 1.200 | Proyectar y truncar en servidor |
| Evidencia de recuperación | 2.500 | Pasajes superiores con citas |
| Memoria relevante | 600 | Solo hechos frescos y atribuibles |
| Margen de trabajo | 900 | Dejar espacio para la siguiente observación |
Son cifras de ejemplo, no una proporción universal. Registra elementos seleccionados, excluidos y truncados por fuente. Luego evalúa tareas con respuesta errónea o bucle. Si se excluyó evidencia correcta, ajusta recuperación o asignación. Si entró demasiada evidencia, mejora selección antes de ampliar la ventana de contexto.
Mantén el ciclo acotado y observable
Tras cada llamada de herramienta, resume o almacena observaciones estructuradas fuera de la transcripción y alimenta solo lo relevante para la próxima acción. Limita rondas de herramientas y termina con resultado parcial útil o escalamiento cuando se acabe el presupuesto. Un agente no debe recuperar los mismos documentos ni releer resultados sin cambios por no tener modelo de estado.
La evaluación RAG aporta evidencia para una parte del sistema. Evaluar RAG offline separa recuperación perdida de afirmaciones sin soporte. Para el agente completo, evalúa resultado final, elección de herramientas, información seleccionada y comportamiento seguro ante contexto obsoleto o adversarial. Diseñar contexto mejora la probabilidad de una buena próxima acción, pero no convierte texto no confiable en autoridad ni garantiza corrección.
Sobre el autor
Rodrigo Arenas es arquitecto de software e ingeniero de machine learning en Medellín, Colombia. Construye productos, plataformas y software open source para IA, Data Engineering y Machine Learning: es el creador de Ciaren, sklearn-genetic-opt y PyWorkforce.
¿Vas a construir una plataforma de IA o de datos?
Diseño y construyo sistemas críticos de principio a fin: arquitectura, datos, modelos y producto. Si esa es la escala en la que trabajas, hablemos.